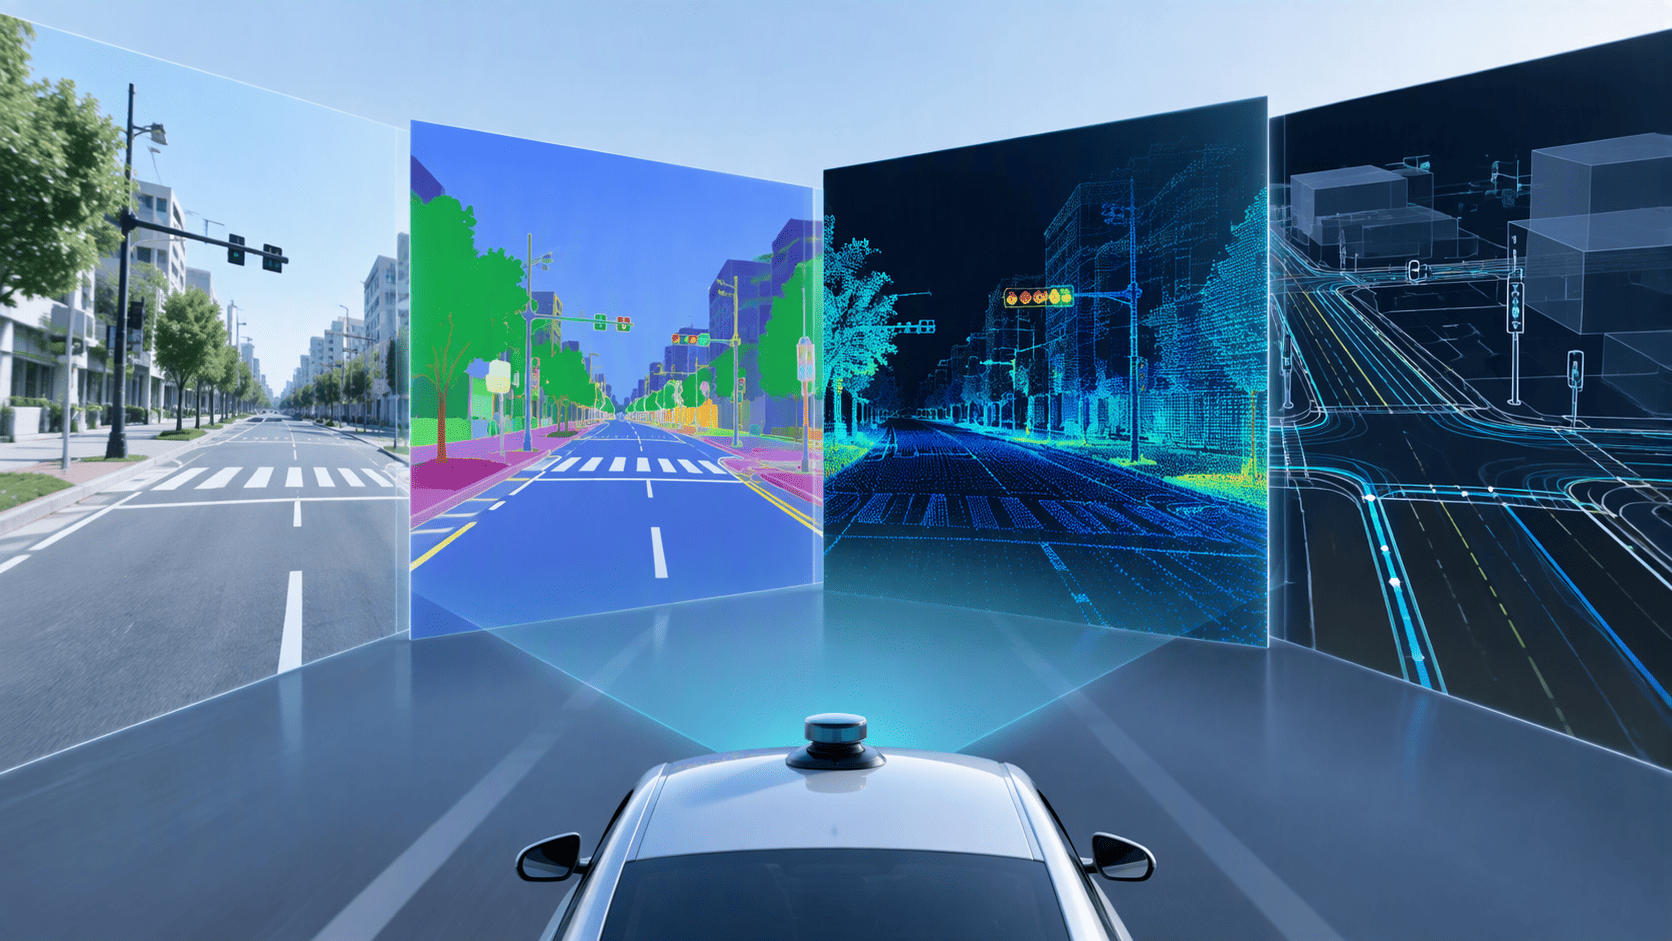
高精度3次元地図データの意味情報を、カメラ画像やLiDAR点群データへ展開する。一見シンプルに思えるこの発想を実現するには、座標整合とオクルージョンなど、さまざまな技術的課題を解決する必要がありました。
今回、ダイナミックマッププラットフォームは、高精度3次元地図データを活用してSemantic ImageやSemantic Point Cloudを生成する技術検証に取り組みました。その過程で、高精度3次元地図データ、LiDAR点群データ、カメラ画像、位置姿勢情報、センサーキャリブレーション情報が、高い空間整合性を持って結び付いていることの価値が改めて見えてきました。
本記事では、Semantic Data生成において直面した課題と、今回の取り組みを通じて再発見した高精度3次元地図データの新たな活用可能性を紹介します。
Semantic Dataとは?Semantic ImageとSemantic Point Cloud
自動運転をはじめとするAI開発では、カメラ画像やLiDAR点群データに「そこに何があるのか」という意味情報を付与したSemantic Dataが活用されています。
Semantic Imageは、画像中の各画素に車線、停止線、横断歩道、標識、信号機などのクラス情報を付与したデータです。一方、Semantic Point Cloudは、点群を構成する各点に道路面、区画線、標識、信号機などのクラス情報を付与したデータです。
カメラ画像は対象の色や模様などの外観を、LiDAR点群データは対象の三次元的な形状を捉えます。これらに意味情報を付与することで、AIはデータを単なる画素や点の集合ではなく、道路空間を構成する要素として扱えるようになります。
ダイナミックマッププラットフォームは、長年整備してきた高精度3次元地図データが持つ静的地物の情報を活用し、Semantic ImageやSemantic Point Cloudを生成できないかと考えました。
しかし実際に取り組んでみると、想像以上に多くの課題がありました。
Semantic Data生成におけるアノテーションの課題
Semantic ImageやSemantic Point Cloudを構築するには、カメラ画像やLiDAR点群データに意味情報を付与する必要があります。この作業は、一般に「アノテーション」と呼ばれます。
代表的な方法として、人が画像や点群データを確認してラベルを付ける人手アノテーションや、AIの推定結果を利用する擬似ラベル生成があります。
しかし、対象となるデータが大規模になるほど、作業コストや品質管理、ラベル定義の一貫性が課題になります。カメラ画像やLiDAR点群データの一つひとつに人手でラベルを付ける方法では、基本的にデータ量の増加に伴って作業量も増えていきます。
そこで私たちは、すでに高精度3次元地図データに格納されている道路地物の意味情報を、Semantic Data生成に再利用するアプローチを考えました。
高精度3次元地図データの意味情報を利用できないか
ダイナミックマッププラットフォームの高精度3次元地図データには、車線、停止線、横断歩道、標識、信号機など、静的な道路地物の位置、形状、属性が構造化された形で格納されています。
つまり、高精度3次元地図データには、道路空間に「何が」「どこに」「どのような形で」存在するのかという意味情報が、地理空間上の位置と結び付いた状態で保持されています。
高精度3次元地図データが保持する静的地物の意味情報をカメラ画像やLiDAR点群データへ対応付けることができれば、ラベルをゼロから作るのではなく、すでに整備された情報をSemantic Dataとして再利用できるのではないか。
発想自体はシンプルでした。
しかし、高精度3次元地図データ上の情報をカメラ画像やLiDAR点群データへ単純に投影するだけでは、AIの学習や評価に使える品質にはなりませんでした。最初に直面したのが、異なるデータ間で位置を正確に合わせる「座標整合」の問題です。
高精度3次元地図データからSemantic Dataを生成する課題① 座標整合
高精度3次元地図データ上に存在する標識や信号機をカメラ画像へ投影しても、期待した位置へきれいに重なるとは限りません。高精度3次元地図データ、LiDAR点群データ、カメラ画像が、それぞれ異なる座標系で表現されているためです。
(参考:【テックブログ】同じ場所なのになぜズレるのか?~空間情報エンジニアが解説する測地系と座標系~)
カメラ画像へ道路地物を投影する場合、概念的には、高精度3次元地図データの地物座標を共通の世界座標へそろえます。次に、撮影時刻におけるカメラの位置・姿勢を使ってカメラ座標へ変換し、カメラ内部パラメータによって画像上の画素座標へ投影します。
LiDAR点群データについても、LiDARと計測基準点との外部パラメータや、取得時刻における位置姿勢情報を使い、共通の座標上へ配置する必要があります。
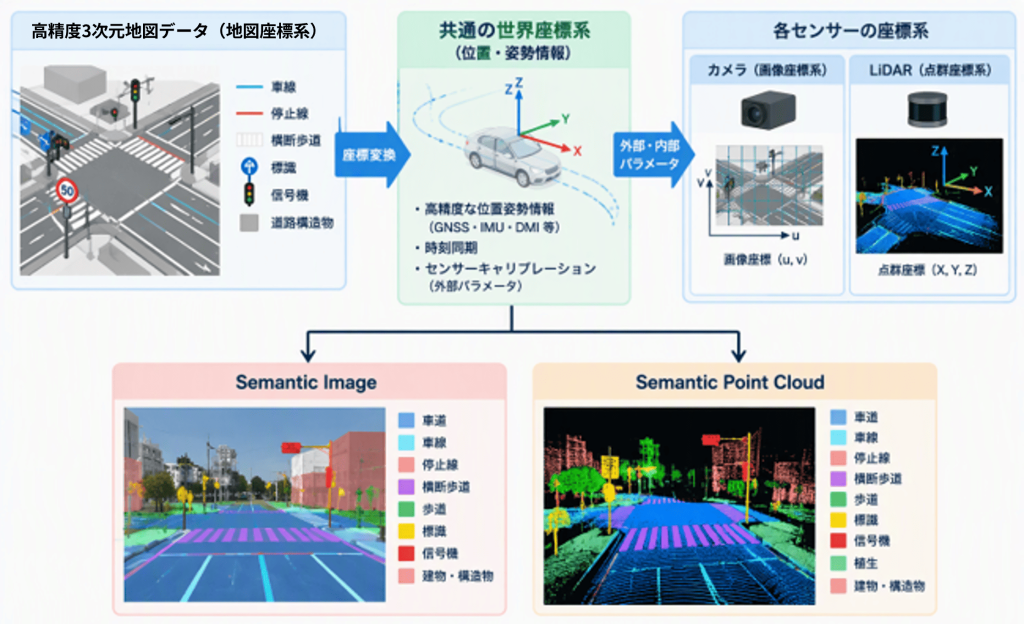
ここで重要なのは、それぞれのデータを単独で高精度に整備するだけでは不十分だという点です。
高精度3次元地図データの位置が正確でも、カメラの取り付け姿勢や撮影時刻との対応に誤差があれば、画像上への投影結果はずれます。逆に、センサーキャリブレーションが正確でも、道路地物の座標や位置姿勢情報が整合していなければ、正しい対応関係は得られません。
画像上のずれの大きさは、対象までの距離、カメラの焦点距離、誤差の方向、カメラ姿勢などによって変わります。そのため、「数cmの位置誤差が、画像上では必ず数ピクセルから十数ピクセルのずれになる」と一律には言えません。
ただし、停止線、区画線、標識ポールのような細い道路地物では、小さな座標誤差や姿勢誤差でもラベル境界の品質に影響しやすくなります。Semantic Dataとして利用できる品質を確保するには、各データの精度だけでなく、データ間の整合性を慎重に確認する必要があります。
高精度3次元地図データからSemantic Dataを生成する課題② オクルージョン
データ間の座標を正しくそろえるだけでも十分ではありません。もう一つの大きな課題が、オクルージョンです。
オクルージョンとは、対象物が別の物体に遮られ、カメラやLiDARから観測できない状態を指します。
高精度3次元地図データには、道路空間に存在する静的な地物が記録されています。しかし、高精度3次元地図データ上に存在する道路地物が、カメラによる撮影やLiDARによる計測の瞬間にセンサーから観測できているとは限りません。
例えば高精度3次元地図データ上に信号機が存在していても、撮影時に大型トラック、バス、樹木、看板などによって遮られている場合があります。
この状態で地物を単純投影すると、画像では見えていない信号機にもラベルが付きます。認識モデル向けのSemantic Imageでは、入力画像から観測できない対象にクラスラベルが付いていると、意図しない学習につながる可能性があります。
そのため、Semantic Dataを生成する際には、対象となる道路地物がセンサーから見えているかどうかを判定する「可視性判定」が必要です。
可視性判定では、対象地物を画像へ投影したうえで、LiDAR点群データから生成したDepth(深度情報)や、別の方法で得られた深度情報、あるいはレンダリング空間のZ-bufferに相当する前後関係などを利用します。視線方向に対象地物より近い観測がある場合、その道路地物は遮蔽されている可能性があると判断します。
ただし、LiDAR点群データは連続した面ではなく、離散的な点の集合です。また、カメラとLiDARでは視野や取得時刻が完全に一致しない場合もあります。
このため、単純な深度比較だけでは、細い地物、点群の疎な領域、物体の境界部分などで誤判定が起こり得ます。
実際の判定では、深度差のしきい値、近傍画素や近傍点の評価、地物形状、センサー間の視野差などを考慮する必要があります。状況によっては、可視性を「可視」「遮蔽」「判定困難」といった複数の状態に分けて扱うことも現実的です。
Semantic Point Cloudについても、同様の課題があります。
高精度3次元地図データ上に停止線が存在していても、計測時に駐停車車両によって路面が遮られていれば、停止線に対応するLiDAR点自体が存在しない場合があります。また、停止線ではなく、その上に停車している車両表面の点だけが取得されている可能性もあります。
したがって、高精度3次元地図データ上の面や線に対応するラベルを、周辺のLiDAR点へ無条件に付けることはできません。実際に観測された点との空間的な近接関係に加え、法線や高さ、地物境界などを考慮してラベルを割り当てる必要があります。
高精度3次元地図データをSemantic Data生成に活用するメリット
座標整合、オクルージョン判定、品質管理まで考えると、高精度3次元地図データを利用する方法も決して簡単ではありません。それでも、このアプローチには人手アノテーションとは異なる大きな利点があります。
人手アノテーションでは、原則としてカメラ画像やLiDAR点群データごとにラベルを付ける作業が発生します。
一方、高精度3次元地図データを起点とする方法では、静的な道路地物の位置・形状・属性があらかじめ構造化されています。その意味情報をSemantic Data生成に再利用できれば、すべてのラベルを一から作成する必要はありません。
初期段階では、データの変換処理や可視性判定の実装、地図上の属性とSemantic Data上のクラスとの対応付け、生成結果の品質検証などが必要です。しかし、処理基盤を整備できれば、多数のカメラ画像やLiDAR点群データに対して、共通のルールを適用できる可能性があります。
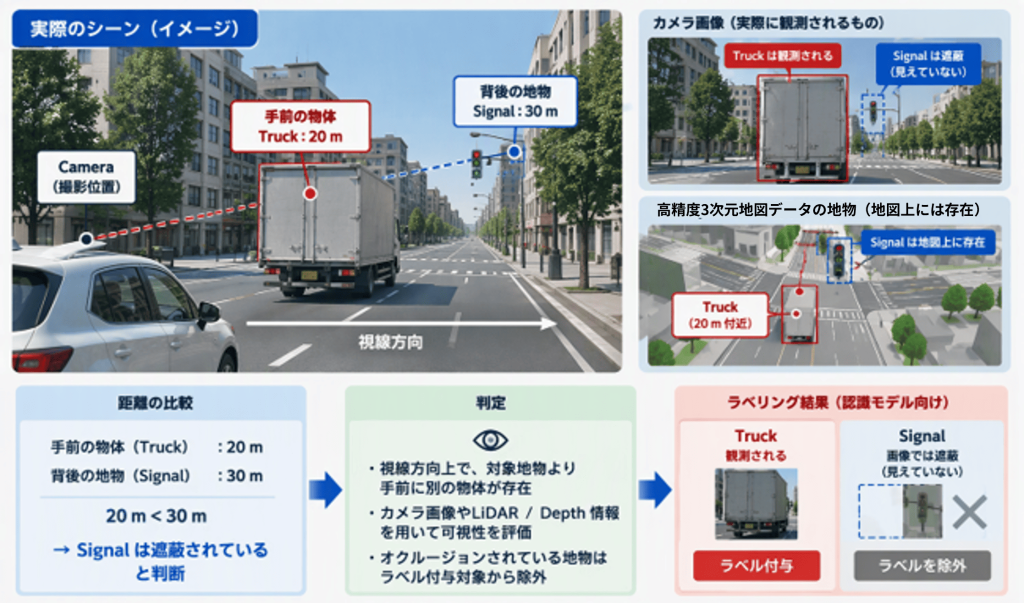
対象地物より手前に別の物体が存在する場合、対象は遮蔽されている可能性があります。
認識モデル向けラベルでは、可視性を考慮した除外や無効化が必要です。
Semantic Image・Semantic Point Cloud生成への技術的な見通し
今回の技術検証では、試行錯誤を重ねながら、高精度3次元地図データが持つ静的な道路地物の情報をカメラ画像やLiDAR点群データへ対応付けました。
その結果、座標整合やオクルージョンなどの課題はあるものの、高精度3次元地図データの意味情報を活用して、Semantic ImageやSemantic Point Cloudを生成するための技術的な見通しを得ることができました。
このアプローチの特徴は、高精度3次元地図データが持つ構造化された意味情報を、画像や点群データ上のラベルへと展開できる点にあります。
道路地物の位置、形状、属性を起点としてラベルを生成することで、ラベルの由来を追跡しやすくなるほか、共通のクラス定義に基づいて、多数のデータへ意味情報を付与できる可能性があります。
今回の取り組みは技術検証の段階です。生成したSemantic DataをAIの学習や評価に利用するには、対象とする用途やモデルに応じて、必要な精度やクラス定義、品質評価の方法を検討する必要があります。
データ同士のつながりから見えてきた価値
今回の技術検証を支えたのが、高精度3次元地図データ、LiDAR点群データ、カメラ画像、高精度な位置姿勢情報、センサーキャリブレーション情報のつながりです。これらのデータが、実世界の同じ位置・時刻と対応付けられる形で蓄積されていたことが、今回の取り組みにつながりました。
高精度3次元地図データは道路地物の意味と構造を持っています。LiDAR点群データは道路空間の三次元形状を、カメラ画像は対象の色や模様などの外観を捉えています。
さらに位置姿勢情報、時刻同期、センサーキャリブレーション情報が、これらのデータを共通の空間へ結び付けます。
この関係があるからこそ、高精度3次元地図データが持つ道路地物の意味情報を、カメラ画像やLiDAR点群データへ展開することが可能になります。
今回の取り組みを通じて私たちが再発見したのは、個々のデータの精度や情報量だけではなく、異なる種類のデータが、高い空間整合性を持って結び付いていること自体が、大きな価値を持つということでした。
世界180万km超の高精度3次元データが持つ可能性
今回得られた技術的な見通しを、今後より多様な道路環境へ展開していくうえで重要になるのが、高精度3次元データの規模と多様性です。
ダイナミックマッププラットフォームは、日本、北米、ヨーロッパ、中東、韓国の主要道路を網羅する、全世界合計180万km超の高精度3次元データを保有しています。高精度3次元地図データに加え、道路や周辺地物の三次元形状を捉えたLiDAR点群データなど、実世界の道路空間を捉えたデータを蓄積しています。
重要なのは距離の大きさだけではなく、異なる道路環境を含む多様性です。
- 道路・レーンの構成や設計思想
- 標識・信号機などの体系
- 交通規制や走行環境
- 都市、高速道路、インターチェンジなどの道路形態
単一地域だけを対象としたデータでは、道路構造や交通環境の多様性には限界があります。一方、世界の主要地域にまたがるデータアセットには、異なる道路文化、規制、都市構造が含まれています。
世界180万km超という規模と、複数の主要地域にまたがる多様性を備えた高精度3次元データは、Semantic ImageやSemantic Point Cloudを継続的に生み出し、その活用可能性を検証していくための大きな原資になり得ます。
高精度3次元データから広がるAI活用
今回の取り組みでは、高精度3次元地図データが持つ道路地物の意味情報を、カメラ画像やLiDAR点群データへ展開し、Semantic ImageやSemantic Point Cloudを生成するための技術的な見通しを得ました。
その過程で改めて見えてきたのが、高精度3次元地図データ、LiDAR点群データ、カメラ画像、位置姿勢情報、センサーキャリブレーション情報が、高い空間整合性を持って結び付いていることの価値です。
今回の取り組みは、Semantic Data生成の技術検証であると同時に、ダイナミックマッププラットフォームが長年蓄積してきた高精度3次元データの新しい活用可能性を再発見する機会となりました。
様々なAIモデルが実用化される中、高精度3次元データは、道路空間を理解するAIを支える基盤データとして、新たな価値を持ち始めています。