こんにちは、ソフトウェア技術部のR.M.です。以前のテックブログでは、道路空間の3D Gaussian Splatting(以下「3DGS」)における移動体除去について紹介しました。その後、実際にデータを集めて3DGSの再構成を進める中で、新たに2つの課題に直面しました。
一つは、異なる時間帯に取得した画像をまとめて学習させると、照明条件の違いによって再構成結果がぼやけてしまうこと。もう一つは、大規模な道路シーンを一度に処理しようとすると、GPUのメモリが不足しやすくなることです。
そこで、2026年6月から7月にかけて、「appearance embedding」と「シーン分割」という2つの手法を導入しました。本稿では、それぞれの手法の実装の過程と、そこから得られた学びを紹介します。
複数時間帯のデータが3DGSにもたらす課題
当社では、様々な道路環境において、計測車両によりLiDAR点群やカメラ画像を取得しています。
幅の広い道路や車線数の多い道路では、1回の走行だけでは高精度3次元地図データの作成に必要な道路空間全体のデータを計測することができません。まず一方向を走行して計測し、折り返した後に反対方向を計測するなど、複数回の走行が必要になります。
このような計測では、一方向の撮影時刻と、折り返してからのもう一方向の撮影時刻は異なります。例えば、朝8時に一方向を計測し、その後移動してもう一方向を10時に計測する、といった具合です。
ここでジレンマが生じます。同じ場所であっても、時間が変われば太陽の位置や光の当たり方が変化します。その結果、建物や道路の色味、影の位置、画像全体の明るさなどにも違いが生じます。
3DGSの再構成品質を上げるには、同じシーンを異なる視点から見た画像が多いほど良いというのが基本原則です。しかし、異なる時間帯に取得した画像をそのまま一緒に学習させると、照明条件の違いをうまく処理できない場合があります。
当初、こうした複数時間帯の画像をすべて一緒に学習させていました。直感的には、データ量が多ければ品質も上がるはずです。ところが結果はそうはなりませんでした。異なる色調の画像が混在することで、3DGSを構成するガウシアンが複数の色を平均化しようとします。
その結果、本来なら鮮明であるべきテクスチャがぼやけ、色が不自然に平均化され、全体的に眠い印象の再構成になってしまいました。
データ量を増やすことで視点情報は豊富になる一方、時間帯による見た目の違いが、再構成品質の低下につながっていたのです。
Appearance embeddingとは
この課題に対して導入したのが、appearance embeddingです。
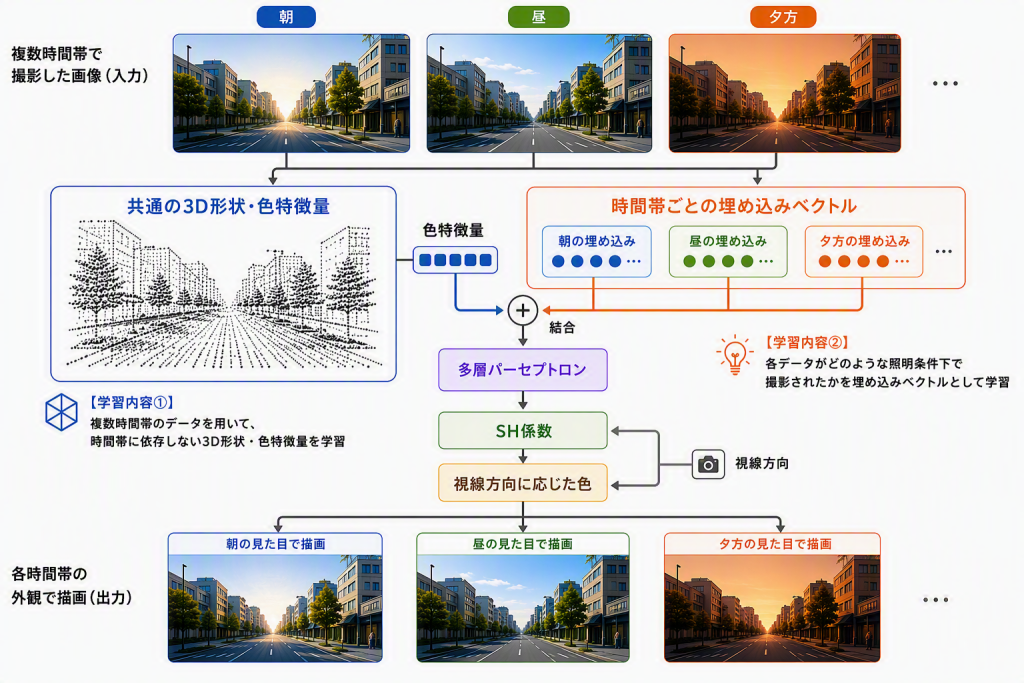
Appearance embeddingとは、撮影時刻や照明条件などによって生じる「見た目の違い」を、ニューラルネットワークが学習できる情報として扱うための仕組みです。
例えば、同じ建物であっても、朝と昼では光の当たり方が異なり、明るさや色味が変化します。Appearance embeddingでは、こうした時間帯ごとの見た目の違いを専用のパラメータとして学習させます。
これにより、物体の形状や基本的な色と、撮影条件によって変化する色調とを分けて扱えるようになります。
Appearance embeddingの導入
Appearance embeddingを導入するにあたり、SplatFacto-W(https://kevinxu02.github.io/splatfactow/)の論文で、「Latent Appearance Modeling」として提案されている手法を採用しました。
基本的な考え方は、色の学習時に、各撮影条件に対応する埋め込みベクトルを用意し、ガウシアン側の色特徴量値と合わせて多層パーセプトロン(MLP)に入力するというものです。MLPは、入力された情報をもとに、各撮影条件に応じた色補正を学習します。
Appearance embeddingで学習する内容は、主に2つに分かれます。
1.形状と色特徴量の学習
3DGSのジオメトリと、時間帯が変わっても共通する基本的な色特徴量情報を、複数時間帯のデータを使って学習します。このとき、各ガウシアンは「どこに存在するか」と「基本的にどんな色か」を学習します。
2.撮影条件ごとの色補正の学習
各データがどのような照明条件下で撮影されたかという情報を、時間帯IDに対応した埋め込みベクトルとして学習します。
例えば、朝に撮影されたデータと昼に撮影されたデータには、それぞれ異なる埋め込みベクトルが割り当てられます。
描画時には、まずガウシアンの色特徴量と、その時間帯に対応する埋め込みベクトルを取得し、MLPに入力します。MLPがSH関数のパラメータを出力し、視線の方向に基づき、RGB値を取得します。
つまり、時間帯による色調の差を単なる「ノイズ」として扱うのではなく、「データの属性」として明示的にモデル化するわけです。
Appearance embeddingを導入した結果
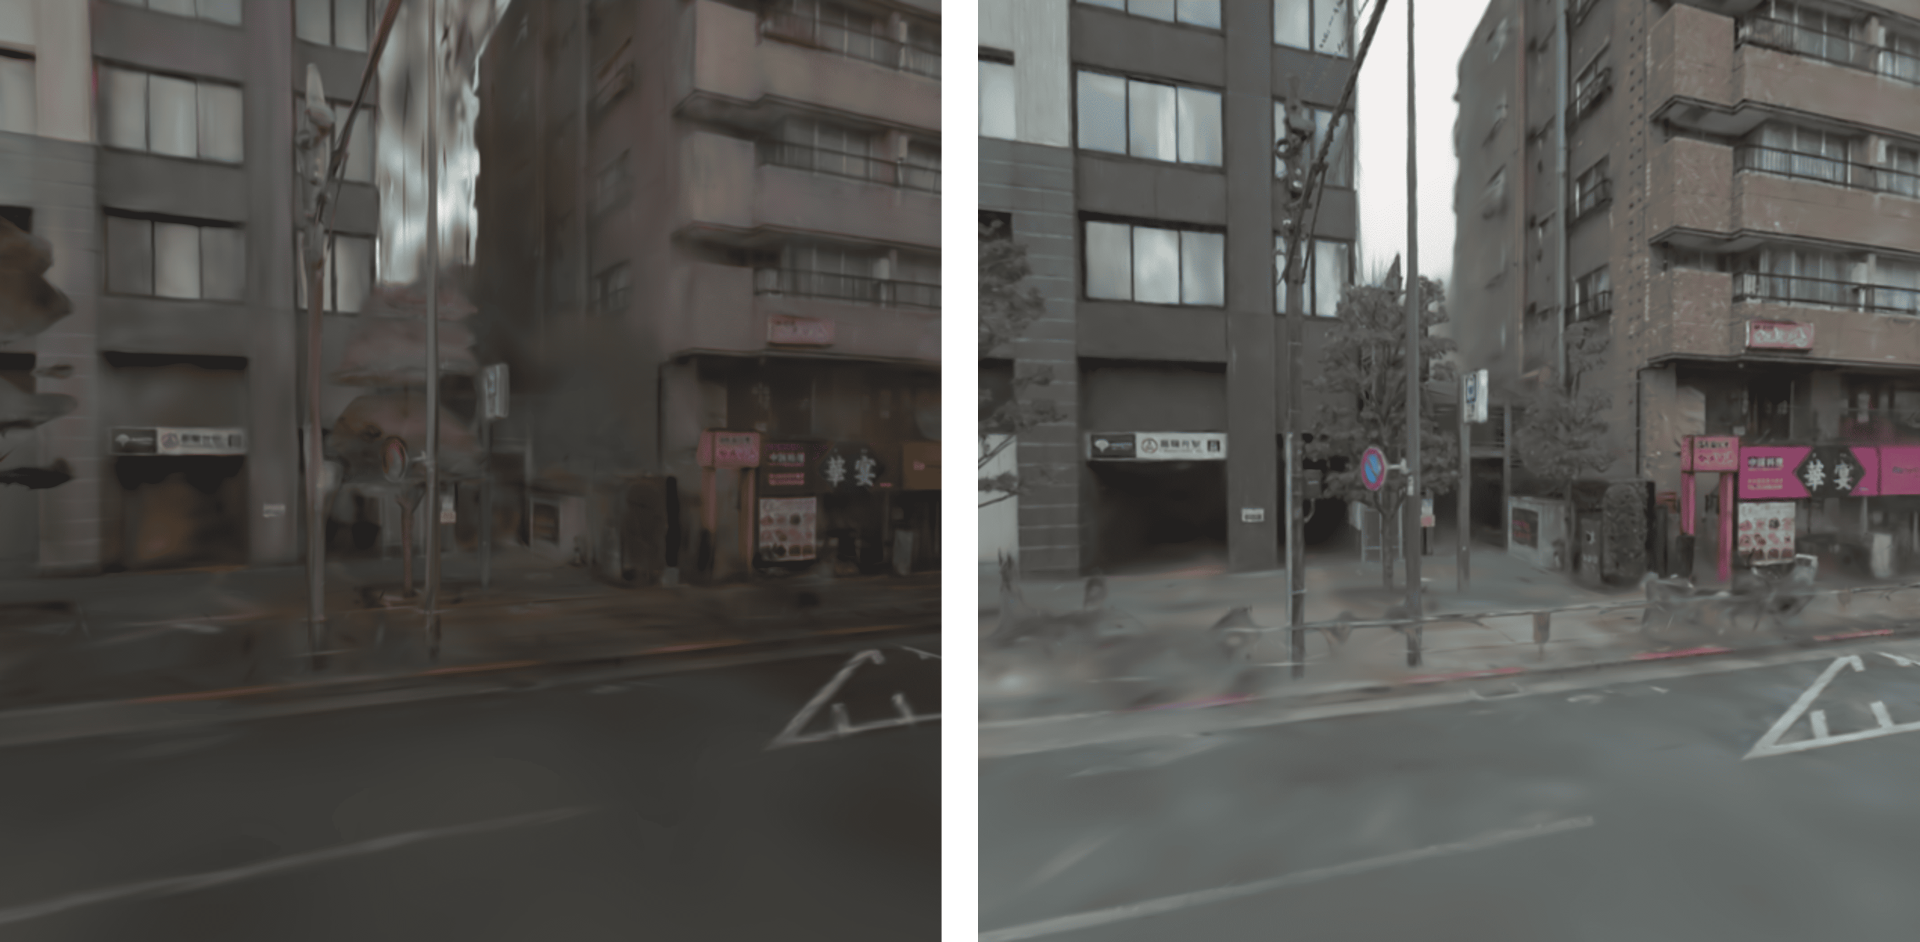
Appearance embeddingを導入することで、異なる時間帯のデータをより効果的に活用しながら、それぞれの色調特性を反映した3DGSを生成できるようになりました。従来の方法と比べてテクスチャの鮮明さが向上し、特に照明変化が大きい領域で、色のにじみやぼやけが軽減されました。
一方で、実装にはトレードオフもありました。
各ガウシアンの色特徴量と各時間帯の埋め込みベクトルを追加することで、GPUのメモリ使用量が大幅に増加しました。また、SH関数を取得するためのMLPの処理が加わるため、処理時間も従来の方法より長くなりました。
大規模な道路シーンをどう処理するか
次に課題となったのが、道路シーンの規模です。
当社が扱うデータは道路シーンが中心で、一般的な物体の3DGSと比べて対象範囲が広く、1シーンあたりのデータ量も大きくなります。
そのため、すべてのガウシアンを一度に最適化しようとするとGPUのメモリが不足しやすくなります。同時に、広い範囲をまとめて最適化することで細部の再現が甘くなる課題も出てきました。
そこで検討したのが、シーン全体を空間的に分割し、段階的に最適化する「シーン分割」です。
シーン分割の処理フロー
今回のシーン分割では、次の3つのステップで処理を行いました。
ステップ1:シーン全体を大まかに最適化する
まず、すべての画像を使用してシーン全体を学習します。
この段階では、細部を高精度に再現することよりも、シーン全体の構造や各領域の大まかな配置関係を把握することを目的としています。
ステップ2:分割領域ごとに詳細を最適化する
次に、シーンを複数の領域に分割します。
各領域に対して、その領域を撮影しているカメラの画像のみを使用して、より詳細な最適化を行います。処理する範囲を限定することで、各領域の細部をより高精度に再現します。
ステップ3:最適化した領域を統合する
各領域の最適化が完了したら、分割した結果を統合し、シーン全体を再構成します。
シーン分割を導入した結果
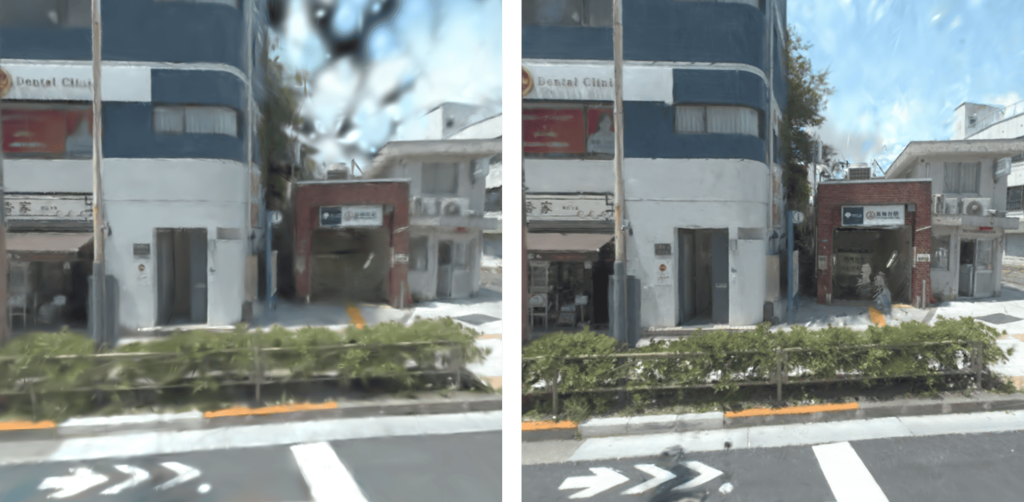
シーン分割を導入することで、一度に処理するガウシアンの数を抑えられるようになり、GPUのメモリ負荷が大幅に軽減されました。その結果、これまでよりも大規模な道路シーンの処理が可能になりました。
同時に、各領域を個別に最適化することで、局所的な特徴を捉えやすくなり、細部を鮮明に再現できるようになりました。
一方で、シーン分割にも処理時間の課題があります。
1枚のGPUで順番に処理する場合、シーン分割は領域ごとに学習を繰り返すため、分割なしの場合よりも全体の学習時間が長くなります。
一方で、複数GPUを使用し、各領域を並列で処理できる環境であれば、短時間で処理することが可能になります。
シーン分割の効果を最大限に引き出すには、対象となるシーンの規模だけでなく、使用できるGPUの数やメモリ容量に応じて、処理方法を設計する必要があります。
実データの特性に合わせて処理を設計する
今回の取り組みを通じて改めて感じたのは、入力データの特性を理解し、それに合わせた3DGS生成パイプラインを構築することの重要性です。
今回用いたappearance embeddingとシーン分割は、対象となるシーンが大規模で、かつ複数時間帯のデータが混在する条件だったからこそ必要になった手法です。一方、例えば机の上のスマホを3DGSにするような、単一時刻で撮影された小規模な静的シーンでは、こうした対応はいりません。
当社が保有する実データには、時間帯による照明の変化だけでなく、多様な道路構造や広い計測範囲など、3DGS生成を難しくするさまざまな特性があります。
しかし、こうした情報は、高精度3次元地図データ生成の観点では非常に有用でもあります。だからこそ、一般的な設定をそのまま当てるのではなく、データ特性に合わせた3DGSパイプラインを設計することが重要だと考えています。
おわりに
「Data for AI」の理念のもと、我々は高品質なAIネイティブデータを作ることを目指しています。
その過程では、3DGSのようなアルゴリズムの工夫ももちろん重要ですが、同時に「どんなデータが集まるのか」「そのデータにはどのような特性があるのか」「その特性をどう活かすか」といったデータとの向き合い方が、結果を大きく左右することを改めて認識しました。
今後も、当社が保有するデータの可能性を最大限に引き出すアプローチを探求し、より高品質な3D再構成の実現に取り組んでいきます。